バイブコーディングのテストはどうするか — 3層の考え方と書き分け
「AI がアプリを作ってくれるなら、テストはどうなるのか?」——バイブコーディングで最も雑談に上がる質問です。結論から言うと、テストはなくならない。むしろ「誰が・いつ・何を確かめるか」の設計が重要になった。生成が速い分、壊れるのも速い。この記事では、Lovable 等で作るアプリのテストを「3層」に分けて整理します。
前提:AI に任せたコードは「見た目で判断できない」
手書きの時代は「自分が書いたから動く理由を知っている」状態がありました。生成コードにはそれがなく、見た目が動いていても条件の抜け(境界・異常系・権限)は画面からは分からない。だから「AI に書かせたものを AI に確認させる」だけでは自己審判になりやすく、人間が持つべき「確認の観点」がむしろ重要になります。
“AI-generated code is optimised for the happy path… What it routinely omits is what happens when a user submits an empty form, a network request times out, an external API returns a 500 error…”
(本文「Vibe Coding Common Mistakes」節)
引用:https://qualityclouds.ai/blog/vibe-coding-common-mistakes-beginners
上記でも言われていますが、生成コードは正常系に最適化され、異常系を落とします。
正常として処理をしてしまい、「なぜかデータが登録されないので、エラーはエラーと書いてくれ」などと命令を書くこともしばしば発生しますので、事前にエラーはエラーと落とすように開発を進める事も必要です。
3層のテスト
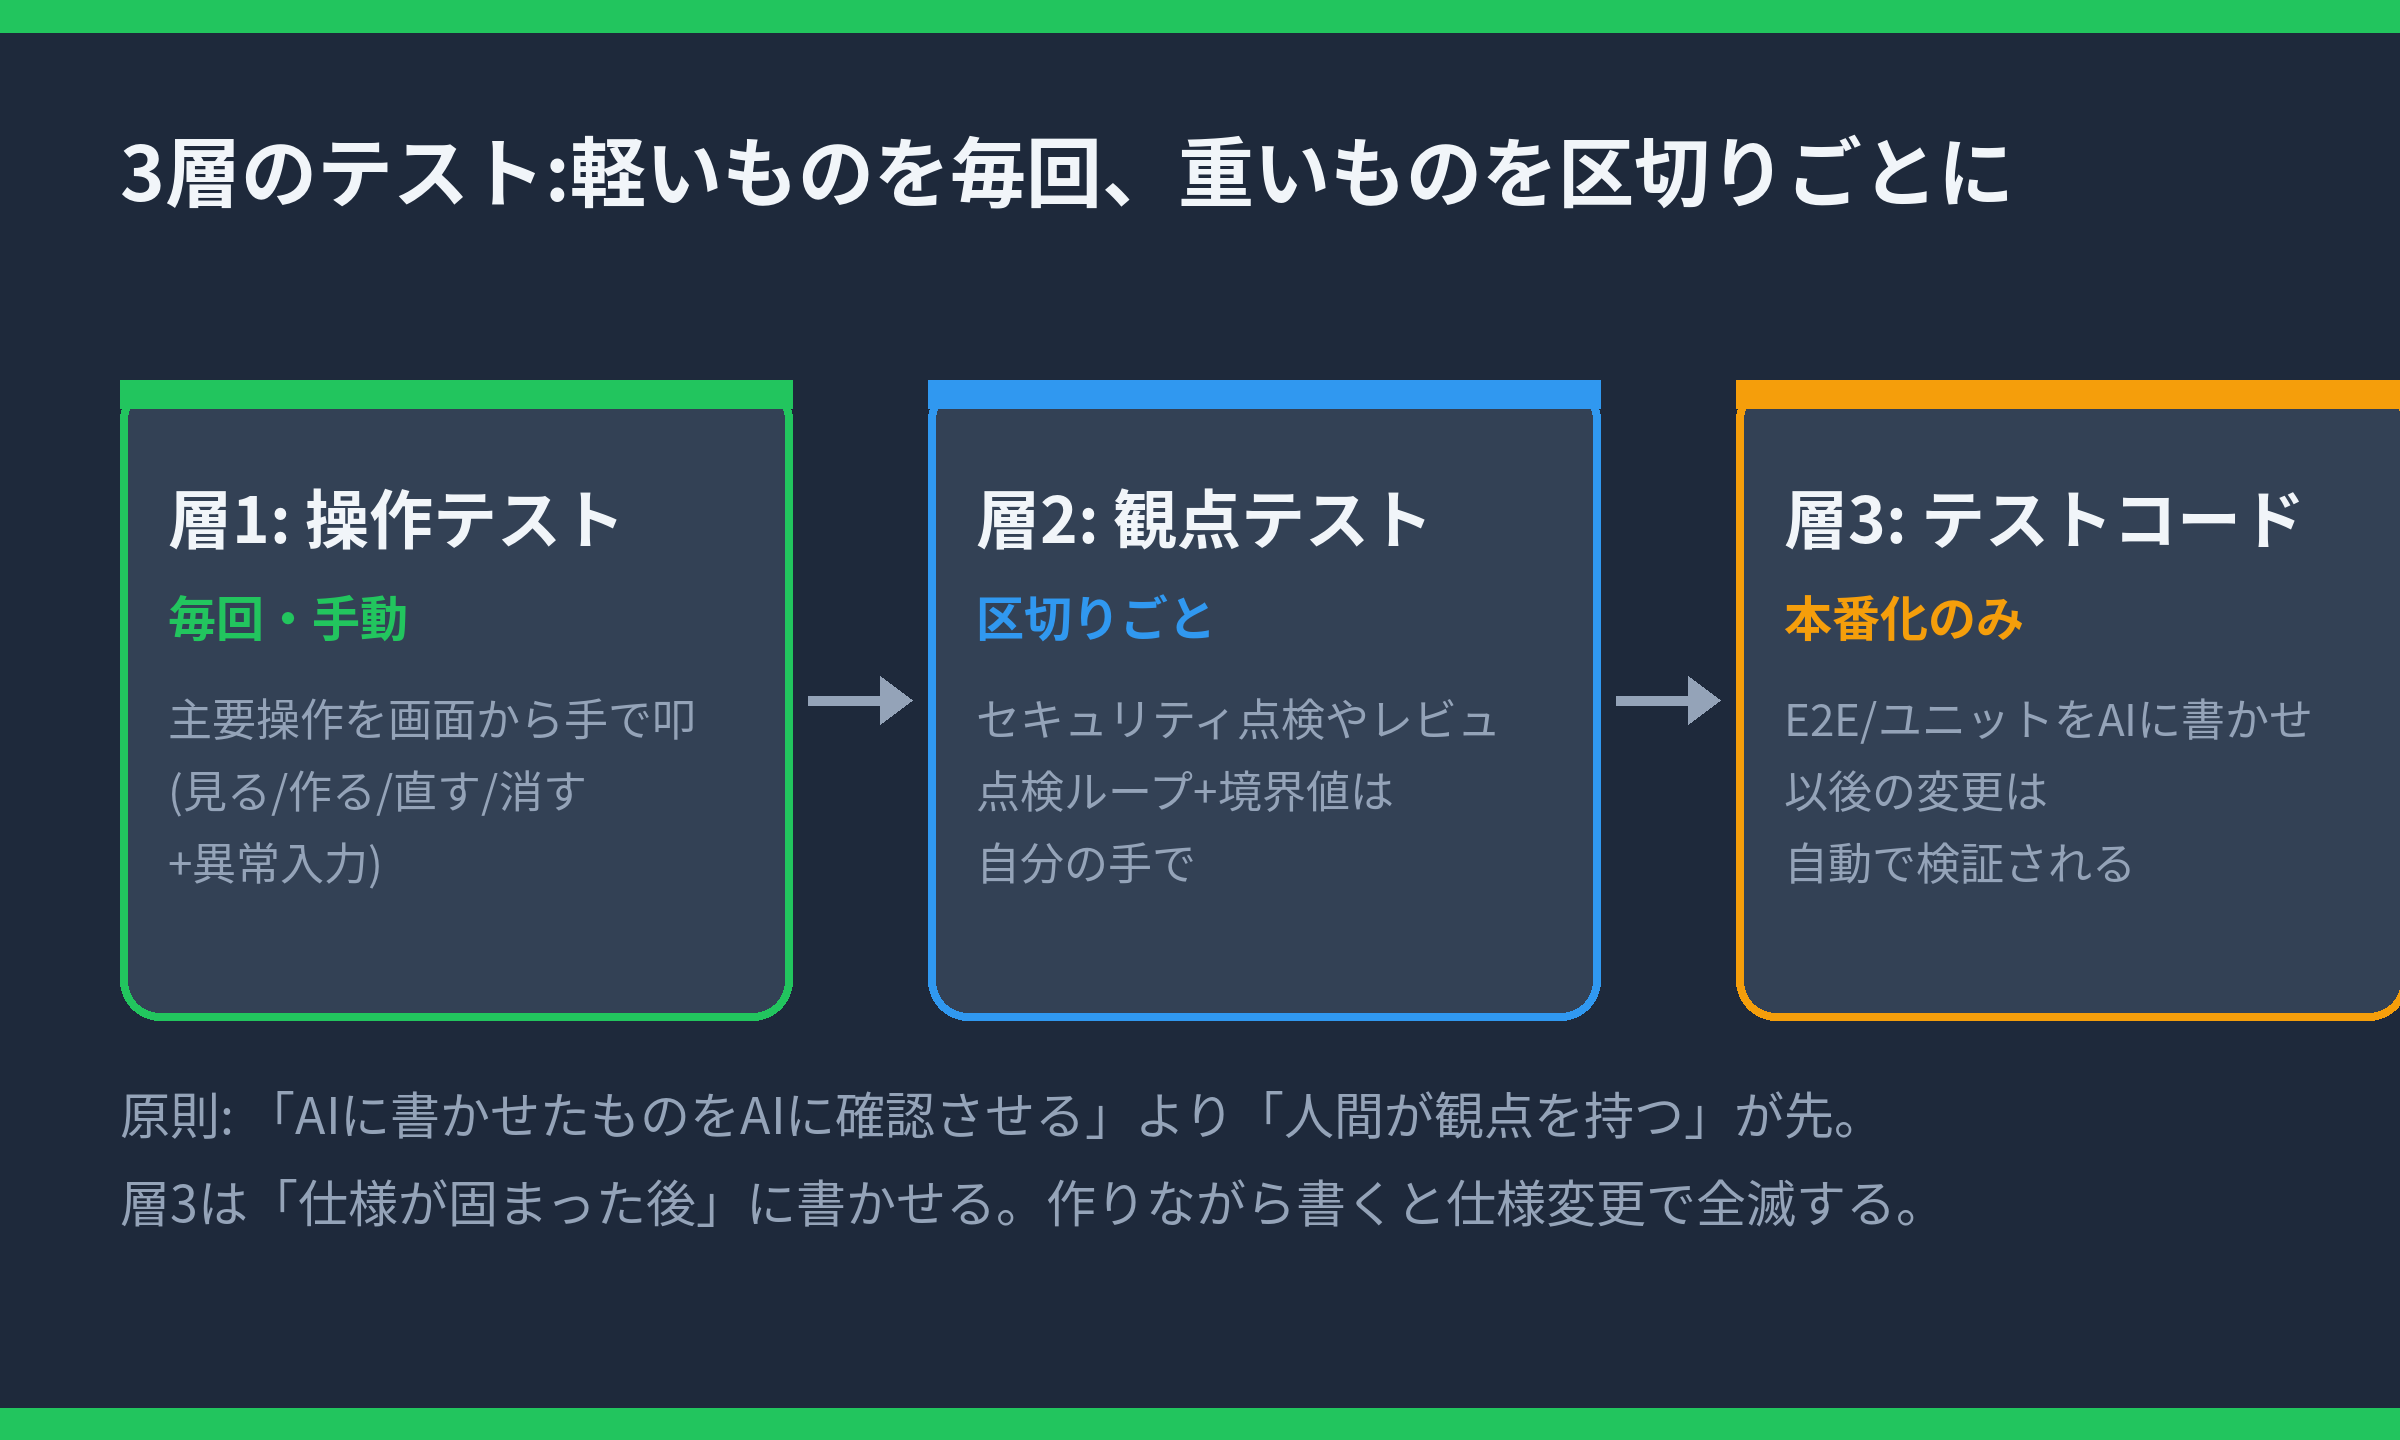
層1: 操作テスト(毎回・手動)
アプリを触るたびに行う最小の確認。「見る・作る・直す・消す」の4操作+異常入力(空欄・長文・変な文字)。要件定義記事の操作の一覧(CRUD)がそのままテストのチェックリストになります。ここで確認できないものは層2以降に回します。
層2: 観点テスト(区切りごと・手動+AI)
機能が増えた区切りで行う点検ループ。筆者の運用では次の4つの定期指示が中心です。
- 「今の状態でセキュリティをチェックして」— RLS・キー露出の点検
- 「今の状態で開発負債がいないかコードレビューをして」— 追加指示の積み重ねで生じた重複・矛盾を拾う
- 「今の状態で一旦仕様をドキュメントで書いて」— 逆引き仕様書。テスト観点の元データになる
- 「今呼び出している Supabase の関数を書いて」— 外部依存の棚卸し
さらに、境界値を自分の手で叩きます(0件・1件・大量、未来日、全角/半角、他人のデータへのアクセス)。AI に頼むと「問題ありません」になりがちなのがこの領域で、手で触れるからこそ見つかる異常があります。
層3: テストコード(本番化する時のみ)
アプリを公開・継続運用する段階で初めて書かせます。依頼は「このアプリの主要操作を自動テストで確認できるようにして。E2E はユーザー視点の主要フロー、ユニットは計算・判定ロジックを中心に」という粒度で。書くタイミングが重要で、作りながら書くと仕様変更のたびにテストが壊れて二重の手間になります。仕様が固まった(=層2の逆引き仕様書ができた)後に書かせるのが効率的です。
書き分けの原則
- プロトタイプ(見せる用) — 層1だけで公開できる。むしろ層3を書く時間で次の改善を回す方が価値が出る。
- 実務利用(使い続ける) — 層1+層2が必須。RLS などセキュリティ観点は層2で毎回。
- 本番・複数人 — 層3を追加。以後の変更は自動テストが検証するので、AI への追加指示も怖くなくなる。
「いつまでに本番化するか」が決まっていないなら、層1・2を維持しつつ層3の導入判断を保留するのが現実的です。逆に、他人が使う・データが残る・お金が動くの3つが揃ったら、層3の導入は先送りにしない方が良い境界線です。
テストコードを AI に書かせる時のコツ
- 観点を人間が列挙してから書かせる — 「ここが壊れたら困る」リスト(5〜10個)を渡すと、意味のあるテストが出る。曖昧なまま頼むと「動くテスト」だけで止まる。
- 失敗するテストから入れる — 「今は失敗するが、直したら成功する」テストを1本作ると、修正の完了判定が機械になる。
- テストの失敗は宝 — 層3が回り始めたら、生成指示のミスも仕様の曖昧さも全部数字で見える。月次の品質レポートにも使える。
まとめ
“By Day 90 of vibe-coded projects, teams typically spend 20% to 30% of sprint capacity on bugs tracing to AI-generated code.”
(本文「AI-Generated Code Volume and the Quality Crisis」節)
引用:https://keyholesoftware.com/vibe-coding-trends-2026/
AI 生成コード起因のバグにスプリント能力の2〜3割を消費とも言われています。
実際作っていると、微妙な変更が適宜発生し、それを修正するとバグになり、、という事は発生します。
テストは「AI に任せる/任せない」の二択ではなく、軽いものを毎回、重いものを区切りごと、自動化は本番化の時という加重配分の問題です。3層図をそのままチェックリストにして、セキュリティ点検(セキュリティ確認プロンプト記事)と併用するのがお勧めです。
Share this content:
コメントを送信